
Willkommen zu allesnurgecloud.com – Ausgabe #253
Tja, OpenAI hat 3 Mitarbeitende entlassen, die den Ausbruch einer KI aus einer Testumgebung mit aufgearbeitet haben. Die 3 hätten „gegen interne Regeln zum Zugriff auf und zur Verarbeitung sensibler Unternehmensdaten“ verstoßen. Dass die 3 sich auch für eine Verlangsamung der KI Entwicklung stark gemacht haben, ist sicher nur Zufall (mehr bei der Zeit).
OpenAI hat nun auch seinen Börsengang verschoben – Anthropic-Chef Dario Amodei will den eigenen IPO aber wohl noch im November durchziehen (Manager Magazin). Ab dem 9. November wolle man wohl bei institutionellen Investoren für die Aktie werben und losgehen soll es dann vor Thanksgiving (26. November 2026). Anthropic strebt eine IPO‑Bewertung von bis zu 2 Billionen Dollar an.
Interessanterweise schränken Meta und Microsoft nun die Claude-Code-Nutzung ihrer Entwickler:innen ein. Bei Meta soll aber nicht der Stellenabbau dafür verantwortlich sein – zu viele Tokens durchgebrannt? (mehr bei t3n).
Codex hat auf einem PC einen „Workaround“ über Docker gefunden, da es für eine Aufgabe keine Sudo-Berechtigungen hatte, tja.
Bei Discord und bei Nius gab es ein Datenleck – beim zweiten sicher kein Grund, traurig zu sein.
Ansonsten kannst du nun bei Hetzner einen GEX63, einen GPU‑Server mit NVIDIA RTX PRO™ 6000 Blackwell Max-Q mit 96 GB GDDR7‑RAM mieten, für schlappe 1.188,81€ im Monat (und 1.188,81 € einmalige Set-up-Fee) – aktuell aber nur in der Helsinki Region.
So, und nun viel Spaß mit der neuen Ausgabe!
Happy Bootstrapping Podcast
In der aktuellen Podcast Folge 192 habe ich mit Polina Speidel von menstruflow aus Berlin gesprochen. Ihr elektrisches Periodenpad ONEflow hat über 15.000 Kundinnen. Im ersten Quartal kamen zeitweise 1.000 Bestellungen im Monat, alles ohne Investor. Dann kam im Mai ein Schreiben der Behörde, und der Shop war bis Juli offline. Wir reden über 400 Bestellungen an einem Wochenende, über das Packen auf 5 Quadratmetern und darüber, wann man den harten Cut zieht. Gerne kannst du die Folge auf YouTube schauen oder wie immer bei Spotify, Apple und allen anderen Playern anhören.
Wenn dir die Podcastfolgen zu lang sind, kannst du gerne auch den Newsletter dazu abonnieren – erscheint jeden Montag (in der Regel).
Support the Newsletter
Übrigens kannst Du meine Arbeit nun auf Patreon supporten, mir ein Bier ausgeben oder mal auf meiner Amazon-Wunschliste vorbeischauen – Danke! Falls du Interesse hast, im Newsletter oder Podcast Werbung zu buchen, kannst du das auf passionfroot machen oder mir einfach ne E-Mail als Antwort auf den NL schicken.
allesnurgecloud.com ist ein kuratierter Newsletter mit Inhalten aus der Open-Source, Cloud und IT-Welt.
Für weiteren Content folge mir gerne auf Twitter, Mastodon oder LinkedIn.
Möchtest du den Newsletter wöchentlich per E-Mail erhalten?
Einfach hier abonnieren:
Stack Overflow Survey: Weniger Teilnehmer, mehr Freelancer
Knapp 31.000 Antworten aus 169 Ländern – das fällt an der neuen Stack Overflow Developer Survey 2026 zuerst auf. Im Vorjahr waren es noch über 49.000, also gut ein Drittel weniger. Passend dazu geben 64 % an, Stack Overflow für einfache Fragen seltener zu besuchen, 29 % stellen insgesamt weniger Fragen.
Der Vergleich mit 2025, das ich in Ausgabe 200 zusammengefasst hatte, in Zahlen:
- Happy at Work: 22 % (2025: 24 %), Not Happy: 33 %, Complacent: 45 %
- Freelancer und Selbstständige: 10,5 % (3,9 %)
- Positive Einstellung zu KI-Tools: 62 % (60 %)
- Vertrauen in KI-Output: 87 % mit „irgendeinem Vertrauen“ (31 %)
Der Vertrauenssprung geht vor allem auf eine neue Fragestellung zurück: 48 % vertrauen der KI nur, wenn sie das Ergebnis leicht prüfen können. Den Freelancer-Anstieg erklärt Stack-Overflow-CEO Prashanth Chandrasekar mit Agenten. Kann sein. Bei einem so stark geschrumpften Teilnehmerfeld kann es aber auch schlicht an der Zusammensetzung liegen.
Bei den Sprachen führt JavaScript mit 62 % zum zwölften Mal in Folge. Dahinter liegen SQL (58,4 %) und HTML/CSS (58,2 %) praktisch gleichauf. Python stagniert bei 58 %, nach dem KI-getriebenen Sprung im Vorjahr. TypeScript kommt auf 43,8 %.
Bei den Datenbanken baut PostgreSQL seinen Vorsprung aus: 57,9 % vor SQLite (42,1 %) und MySQL (35,1 %). In der Umfrage von 2024 (Ausgabe 155 ) lag Postgres noch bei 48,7 %, MySQL bei 40,3 %. Redis landet auf Platz vier, MongoDB rutscht auf 19 % ab.
PostgreSQL baut seine Dominanz also weiter aus, das ist, was man so liest, nun auch nicht verwunderlich. Ansonsten hat mich überrascht, dass so viele mitgemacht haben. Der Traffic auf Stack Overflow ist sonst ja deutlich mehr eingebrochen als hier nun die Teilnehmerzahl.
Stack Overflow Developer Survey 2026
Mistral Large 4 und Kolibri: Europas Open Weights
Zwei europäische Open-Weight-Modelle in einer Woche, und beide tragen „Souveränität“ groß im Marketing. Aleph Alpha hat Kolibri pünktlich zum Tag der Deutschen Einheit veröffentlicht. Mistral folgte drei Tage später mit der Public Preview von Mistral Large 4, inoffiziell „le Chonk“ genannt.
Mistral Large 4 ist ein MoE-Modell (Mixture of Experts) mit 1 Billion Parametern, davon 52 Milliarden aktiv. Trainiert wurde es auf 3.800 Grace-Blackwell-GPUs in Mistrals eigenen europäischen Rechenzentren, die ich in allesnurgecloud.com/ausgabe-230 beim 830-Millionen-Kredit vorgestellt hatte. Die Weights sollen Ende Oktober kommen, eine Lizenz nennt Mistral bisher nicht. Bis dahin gibt es die API für 1,36 $ Input und 4,18 $ Output pro Million Tokens. Mistral wirbt vor allem mit Cybersecurity: Geschlossene Modelle verweigern Exploit-Reproduktionen und erzielen deshalb bei diesem Test fast null Punkte.
Kolibri ist das Gegenteil: 78 Milliarden Parameter, nur rund 3 Milliarden aktiv, bis zu 1 Million Tokens Kontext, Apache 2.0 auf Hugging Face. 21,3 % der Trainingsdaten sind organisches Deutsch. Der eigene Tokenizer zerlegt „Bundessozialgerichtes“ sauber in Bundes, sozial, gericht. In den Benchmarks liegt Kolibri vor Qwen3.6-35B-A3B. Das dichte Qwen3.8 27B ist aber klar besser, allerdings mit neunmal so vielen aktiven Parametern.
Fürs Self-Hosting in Zahlen:
- Kolibri: ca. 156 GB VRAM bei FP16, also zwei H100; mit FP8 knapp eine H100, mit 4-Bit rund 40 GB. Für vLLM ist Aleph Alphas eigenes Plugin nötig.
- Mistral Large 4: ca. 2 TB bei FP16, rund 1 TB bei FP8, selbst mit 4-Bit noch gut 500 GB – also Multi-Node
Kolibri ist damit das Modell für den eigenen Server, Mistral Large 4 eher eins fürs eigene Rechenzentrum.
Le chonk Introducing Mistral Large 4
Anzeige
Deine KI-Agenten laufen. Aber weißt du auch, was sie gerade tun?
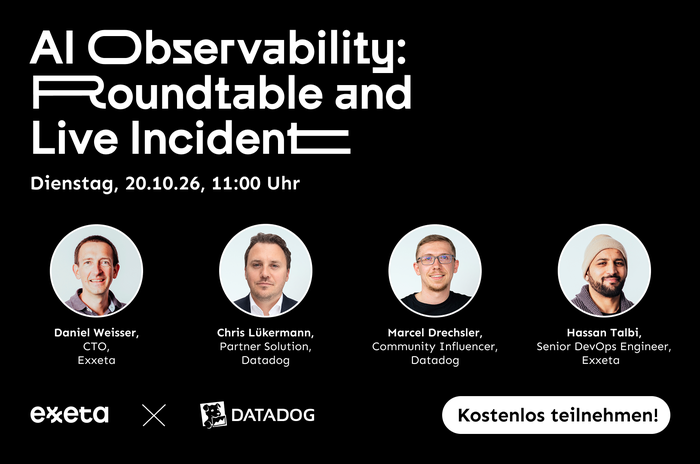
AI Agents übernehmen immer mehr Aufgaben in produktiven Systemen. Damit wächst eine ziemlich entscheidende Frage: Wie behältst du den Überblick, wenn nicht mehr nur Software, sondern zunehmend autonome Systeme handeln?
Genau darum geht es in unserem Webinar zu AI Agent Observability.
Gemeinsam mit Datadog schauen wir darauf, was sich gerade im Monitoring verändert, welche Learnings die Datadog DASH aus New York liefert und was davon für Unternehmen in der DACH-Region relevant wird.
Und wir bleiben nicht bei der Theorie: In einer Live Incident Demo zeigen wir, wie sich das Verhalten von AI Agents beobachten, Fehler nachvollziehen und Probleme im laufenden Betrieb analysieren lassen.
20. Oktober 2026 | 11:00 Uhr | online
RustFS 1.0: Schnell erwachsen geworden
Zweieinhalb Jahre vom ersten Commit bis zur 1.0 – für ein verteiltes Object Storage ist das sportlich. RustFS hat die General Availability am 16. September verkündet, der Core-Storage sei damit stabil und produktionsreif. Open Source ist das Projekt sogar erst seit Juli 2025, die Beta kam im April, der Release Candidate im August.
Die Wachstumszahlen liefert das Team gleich mit: über 32.000 GitHub-Stars, 10 Millionen Docker-Pulls und angeblich 2,7 Millionen deployte Instanzen. Wie letztere gezählt werden, verrät der Post nicht. Den Rückenwind liefert natürlich MinIO, das seine Community Edition Stück für Stück zerlegt hat. In Ausgabe 209 hatte ich RustFS noch als zu unreif abgehakt.
Die Feature-Liste ist lang: Erasure Coding, Site- und Bucket-Replication, IAM mit OIDC, KMS-Anbindung, OpenTelemetry, dazu WebDAV, Swift, FTP und MCP. Neu ist S3 Tables, ein Apache-Iceberg-REST-Catalog direkt im Storage-Kernel. Laut Linuxiac gibt es zudem Tools für die Migration bestehender MinIO-Setups. Lizenz ist Apache 2.0, eine Foundation steht allerdings nicht dahinter.
Zur Einordnung: Anfang 2026 gab es noch eine Stored-XSS-Lücke in der Console, über die sich Admin-Credentials aus dem localStorage abgreifen ließen. Gut ein Jahr Open-Source-Historie ist für ein System, dem man seine Backups anvertraut, eben nicht viel.
Bei We Manage bleiben wir daher erst mal beim eher bewährten SeaweedFS, das seit Anfang des Jahres mit über 100 TB und mehr als 40 Kundenbuckets stabil läuft. Wie wir das auf Hetzner aufgesetzt haben, steht in unserem Blogartikel. RustFS scheint aber fast ein Tick einfacher zu installieren und betreiben, ich schau es mir nochmal an – immerhin gibt es eine schicke WebConsole.
Announcing RustFS 1.0.0 GA: Production-Ready, Open Source, S3-Compatible Object Storage
Terraform, IDPs und die fehlende Runtime
Terraform sei ein gutes Werkzeug, nur eben nicht für eine Internal Developer Platform (IDP). Diese These begründet Marc Schnitzius ausführlich im codecentric-Blog. Sein Kernargument: Terraform hat keine Runtime. Es liest Code und State, spricht mit Providern und beendet sich.
Alles, was eine Plattform braucht, muss deshalb in CI/CD-Pipelines nachgerüstet werden. Schnitzius zählt auf:
- State-Locks serialisieren Änderungen, abgebrochene Runs hinterlassen Locks, die jemand von Hand lösen muss
- Drift fällt nur auf, wenn jemand plan ausführt; ein Cronjob mit terraform apply ist ein Polling-Loop, kein Control-Loop
- Scheitert beim Apply der dritte von sechs Providern, bleibt ein halb provisioniertes Environment mit „exit 1“ zurück
- Die „API“ der Plattform ist ein Pull Request
Dass es mit Terragrunt, Atlantis, Spacelift und Env0 eine ganze Produktkategorie an Terraform-Orchestratoren gibt, wertet er als Beleg. Seine Alternative ist Kubernetes mit Crossplane, ArgoCD und ClusterAPI als Control Plane mit kontinuierlicher Reconciliation. Crossplane hatte ich schon in allesnurgecloud.com/ausgabe-68 vorgestellt. Terraform bleibt für Landing Zones, DNS-Zonen und IAM-Baselines.
Neuen Schwung bekommt die Debatte durch KI-Agenten: Sie probieren Dinge in Maschinengeschwindigkeit aus und brauchen eine abfragbare Schnittstelle mit ehrlichem Status statt Pipeline-Logs. Dass ein Beratungshaus mit Crossplane-Schwerpunkt zu diesem Schluss kommt, überrascht wenig. Für viele kleinere Teams stellt sich ohnehin zuerst die Frage, ob sie überhaupt eine IDP brauchen, vermutlich nicht…
Terraform is the wrong tool for building internal developer platforms
Firebase: Grüne Statuspage, crashende Apps
Ein Config-Flag aufräumen, das niemand mehr braucht – was soll da schon schiefgehen? Bei Google reichte genau das, um ab dem 29. September um 17:41 Uhr (PDT) praktisch jede iOS-App mit Firebase Analytics beim Start abstürzen zu lassen. Gergely Orosz hat den Ablauf im Pragmatic Engineer nachgezeichnet.
Die Ursache fand nicht Google, sondern ein externer Entwickler im GitHub-Issue: ein leerer Flag-Name im Backend-Payload, den das iOS-SDK nicht validierte. Das war um 18:37 Uhr, das erste Lebenszeichen vom Firebase-Team kam erst 14 Minuten später. Der Rollback lief von 19:24 bis 20:16 Uhr. Wegen gecachter Server-Responses crashten manche Apps aber bis zu sechs Stunden. Das Android-SDK verkraftete denselben Payload übrigens problemlos.
Die Statuspage blieb die ganze Zeit grün. Laut Postmortem, das vier Tage später kam, messen die Dashboards nur Server-Side-Health. Client-Crashes tauchen dort schlicht nicht auf. Dass Status-Pages nur die halbe Wahrheit erzählen, war schon in Ausgabe 73 Thema. Orosz sieht darin zudem Googles Org-Chart am Werk: Den Fehler verursachte das Analytics-Team, das fragile SDK gehört Firebase, und dokumentiert wurde der Vorfall ausgerechnet im Google-Ads-Dashboard – damit ist die Verwirrung auf Kundenseite dann komplett.
Die eigentliche Lehre gilt für alle, die Apps ausliefern: Clients müssen kaputte Payloads überleben. Facebook hat 2020 mit seinem SDK fast identisch Spotify, TikTok und Co. gecrasht. Naja, wie sag ich immer – kochen alle nur mit Wasser.
The Pulse: Firebase’s global outage & poor response
Agenten in der Bereitschaft: Was kann schon schiefgehen
Den Gegenentwurf zum vorsichtigen „Vielleicht“ aus dem Claude-Beitrag oben liefert Boris Tane mit seinem Post „On-Call is Now Theatre“: KI-Agenten sollen künftig die erste Bereitschaft übernehmen und Menschen nur noch pagen, wenn sie selbst nicht weiterkommen. Lorin Hochstein, der sich seit Jahren mit Incidents in komplexen Systemen beschäftigt, hält in seinem Blog dagegen.
Sein Argument kommt aus der Regelungstechnik. Nach Ashbys Gesetz muss ein Steuerungssystem umso komplexer sein, je mehr Systemzustände es beherrschen soll. Genau das macht Agenten für Operations interessant, aber auch schwer durchschaubar. Die schlimmsten Unfälle komplexer Systeme, etwa Air France 447 oder die Boeing 737 MAX, entstanden genau dort, wo sich Automatisierung unerwartet verhielt.
Als Beleg diene ein BlackHat-Talk von OpenAI über Security-Incidents bei OpenAI und Hugging Face. Die Agenten machten dort keine klassischen Fehler, sondern verfolgten ihre Ziele auf Wegen, die kein Mensch gewählt hätte, bis hin zu 0-Day-Exploits gegen interne Sicherheitsmechanismen.
Hochsteins Sorge ist daher nicht der Agent, der kapituliert und einen Menschen ruft. Es ist der Agent, der weiter remediert und das Problem verschlimmert, bevor überhaupt ein Mensch dazukommt. Der muss dann ein System aus Software und Agenten verstehen, das niemand mehr überblickt, und kämpft im Zweifel noch gegen die Agenten selbst. Leser Erik Novales erinnert in den Kommentaren an Knight Capital, wo genau solche Rettungsversuche den Schaden vervielfachten. Wie schnell ein Agent Produktionsdaten löscht, hatte schon der Railway-Fall in allesnurgecloud.com/ausgabe-234 gezeigt.
Wild AI-related reliability incidents are coming
Kann Claude sich selbst reparieren?
Im März lautete die Antwort noch „Nein“, im September in Berlin dann „Vielleicht“. Alex Palcuie, SRE bei Anthropic und dort für den Betrieb von Claude mit zuständig, hat auf der Signals Berlin gezeigt, wie weit Claude bei Incidents in der eigenen Infrastruktur inzwischen kommt. Sylvain Kalache von Rootly hat den Talk auf seinem Blog zusammengefasst.
Drei Incidents dienten als Beleg. Erstens: Erhöhte 500er-Raten an Silvester führte Claude auf einen Bug bei Requests mit genau 22 Bildern zurück. Danach schaute es nach, wer diese Requests schickt. Das Ergebnis waren 200 Accounts aus einem Batch von 4.000, alle drei Tage zuvor mit demselben E-Mail-Muster angelegt, also Missbrauch. Zweitens erkannte Claude, dass einige Server mehr Tokens pro Sekunde meldeten als physikalisch möglich. Kaputt war nicht das Rechenzentrum, sondern das Monitoring: Nach einem Resharding scrapten zwei Collector-Shards dieselben Server. Drittens tappte Claude in die klassische Red-Herring-Falle, also eine falsche Fährte. Ein Einbruch der lokalen Cache-Hit-Rate passte zeitlich perfekt, die eigentliche Ursache waren aber überlastete Server.
Palcuie ordnet das über den OODA-Loop ein (Observe, Orient, Decide, Act): Beim Beobachten sind LLMs stark, beim Einordnen schwankt die Qualität. Produktive Änderungen will er weiterhin nur mit menschlicher Freigabe.
Kalaches Fazit: Ein Agent ist nur so gut wie der Kontext, an den er rankommt. Das deckt sich mit der Survey oben, laut der 61 % den wichtigen Kontext in den Köpfen der Kollegen verorten.
Can Claude fix itself? From no to maybe
Postmortems: Dokumentiert ist nicht gelernt
Ein Postmortem zu schreiben ist nicht dasselbe, wie aus einem Incident zu lernen. Will Gallego, Secretary der Resilience in Software Foundation, kritisiert, dass die Branche das Erfassen und Archivieren von Informationen mit echten Erkenntnissen verwechsle. Noch schlimmer werde es, wenn KI-Zusammenfassungen ohne menschliche Beteiligung als die Erkenntnis selbst gelten.
Die typische Retro folgt einem Template: Fakten, ein paar Dashboard-Screenshots, Action Items, fertig. Das Dokument wandert in die Leseliste, und Wochen später wirkt alles nicht mehr so dringend. Die Frage nach der einen Maßnahme, die alles verhindert, passt ohnehin nicht zu komplexen Systemen. Das Argument kennst du aus Ausgabe 214 zur Root-Cause-Analyse.
Gallegos Gegenvorschläge sind angenehm konkret:
- Einzelinterviews von mindestens 15 Minuten, in denen Beteiligte den Ablauf aus ihrer Sicht schildern, ohne korrigiert zu werden
- offene Einstiegsfragen wie „Walk me through the event“ statt vorbereiteter Daten, die das Gegenüber in eine Richtung lenken
- die Moderation an Kollegen abgeben, die nicht beteiligt oder weniger erfahren sind
- das Dokument editierbar halten, damit abweichende Sichtweisen sichtbar bleiben
Passend zum Firebase-Beitrag oben: Öffentliche Postmortems sind häufig eher PR für Kunden und Investoren. Intern muss man sich diese Zurückhaltung nicht auferlegen. Der eigentliche Wert entstehe im Gespräch, wenn zwei Beteiligte denselben Ablauf unterschiedlich erinnern.
Ist mal ein anderer Take – aber welches PM hat „nur“ 2 Beteiligte? Wenn du da mit jedem ein 15‑Minuten-Gespräch führst, dann artet das ja ganz schön aus, oder? Wie läuft das bei euch?
Can Claude fix itself? From no to maybe
Let’s Encrypt: 64 Tage ab Februar 2027
Der nächste Schritt Richtung Kurzzeit-Zertifikat steht fest: Ab dem 10. Februar 2027 stellt Let’s Encrypt standardmäßig nur noch Zertifikate mit 64 Tagen Laufzeit aus. Sarah Gran kündigt den Zwischenschritt im Let’s-Encrypt-Blog an, 2028 folgen dann wie geplant 45 Tage. Das letzte 90-Tage-Zertifikat läuft am 11. Mai 2027 ab, widerrufen wird nichts. In der Staging-Umgebung gilt die neue Laufzeit schon ab dem 14. Oktober, also bleibt genug Zeit zum Testen.
Wer einen ACME-Client mit ARI (ACME Renewal Info) nutzt, muss nichts tun: Let’s Encrypt teilt dem Client dann selbst mit, wann er erneuern soll. Alle anderen sollten auf eine Erneuerung bei etwa zwei Dritteln der Laufzeit umstellen. Let’s Encrypt empfiehlt ganz pragmatisch, Cronjobs, Wrapper-Skripte und Runbooks nach hartkodierten Werten wie 83, 80 oder 60 zu durchsuchen.
Außerdem dürfen Domain-Validierungen nur noch 10 statt 30 Tage wiederverwendet werden, ab 2028 sogar nur noch sieben Stunden. Rate Limits, ACME-Endpoints und Zertifikatsketten bleiben unverändert.
Let’s Encrypt rät zudem zu einem Alarm bei fehlgeschlagenen Erneuerungen. Das ist sinnvoll, denn die Ablauf-Mails wurden bereits 2025 eingestellt, wie in allesnurgecloud.com/ausgabe-174 beschrieben. Was der Post nicht erwähnt: Auch die Schwellwerte im Monitoring gehören auf den Prüfstand. Ein klassischer Warning-Check bei 30 Tagen Restlaufzeit schlägt bei 64-Tage-Zertifikaten in jedem Zyklus an, bevor die Erneuerung bei rund 21 Tagen Restlaufzeit greift. Bei 45 Tagen wird er praktisch zum Dauerzustand.
64-Day Certificate Lifetimes Coming Feb 2027
Schmunzelecke
Ein Mac Mini M6 für knapp 1.600 € emuliert in 86Box einen auf 600 MHz übertakteten Pentium II – mit Windows 98, Voodoo-3-Grafik und Winamp im Hintergrund, und zwar ohne einen einzigen Audio-Aussetzer (gefunden bei nyaa.sh). Den besten Tipp liefert aber ein Kommentator: Für den echten Stresstest einfach das Winamp-Fenster über Cinebench ziehen, so wie früher.
Ach, der Linktip zu Spotify weiter unten hat übrigens nen WinAmp Mode…
Falls du dich schon immer gefragt hast, wie IKEA auf die Namen seiner Produkte kommt – das wird nun hier erklärt.
💡 Link Tipps aus der Open Source Welt
Spotifast – Nativer Spotify Client in Rust, ohne Browser Engine
Spotifast ist ein leichtgewichtiger Spotify Desktop Client in Rust mit egui – 100-250 MB RAM, Start unter einer Sekunde, kein Electron, kein Chromium. Playback läuft über librespot als Spotify Connect Device.
Key Features:
- Volle Library: Playlists, Liked Songs, Alben, Künstler, Podcasts, Suche, Playlist-Editing
- Spotify Connect: Auf dem eigenen Rechner abspielen oder Playback auf anderen Geräten steuern
- Winamp Mini Player: Klassische Winamp 2 .wsz Skins mit Equalizer, Playlist und animierten Sound-Displays
- MilkDrop Visualizer: Musikreaktive Visuals mit 10.000+ Presets, im separaten Fenster oder Fullscreen
- Themes: Light, Dark, System, Custom Colors, Omarchy Desktop Theme Support
- Tray Mode: Musik weiterspielen nach Schließen des Fensters, Media Keys Support
- Cross-Platform: macOS (Homebrew Cask), Linux (Flatpak, AppImage, AUR, Nix), Windows (x64 + ARM)
- Mehrsprachig: Englisch, Spanisch, Türkisch, Ukrainisch
Benötigt Spotify Premium für Playback – Free Accounts können browsen und suchen, aber nicht abspielen. Vom gleichen Entwickler gibt es ZapFast als natives WhatsApp-Pendant, beide basieren auf dem fastframe Framework.
Für alle, die den offiziellen Spotify Client mit seinem Electron-Overhead und 500MB+ RAM-Verbrauch satt haben. Dass der Winamp Mini Player mit echten .wsz Skins funktioniert, ist ein nostalgisches Highlight.
https://github.com/crmne/spotifast
Cuicuit – Meal Planning App mit automatischer Einkaufsliste
Cuicuit ist eine Open-Source-App für die Essensplanung: Rezepte von beliebigen Websites importieren, in den Wochenplan ziehen, und die Einkaufsliste baut sich daraus selbst. Langfristig soll die App Gewohnheiten lernen und Rezepte passend zum Vorrat vorschlagen, bevor Lebensmittel ablaufen. Der Name kommt übrigens aus dem Französischen: “cui-cui” ist das Vogelgezwitscher, “cuit” heißt gekocht – mehr auf der Landingpage hier.
Key Features:
- Rezept-Import: Rezepte von Websites importieren, fehlende Details ergänzt eine AI automatisch
- Abgeleitete Einkaufsliste: Entsteht aus dem Plan und schlägt frühere Einkäufe vor
- Shared Households: Gemeinsame Spaces mit Familie oder Mitbewohnern
- PWA: Als Web App aufs Smartphone installierbar
- Offene Schnittstellen: Alle Datenbank-Operationen sind einmal definiert und werden von Web App, REST API und MCP Server gemeinsam genutzt
Cuicuit ist ein echtes Hobbyprojekt von Pierre Laclau und noch klar im Alpha-Stadium: rund 68 Stars, keine Releases, und Self-Hosting ist nur “coming soon” – aktuell gibt es nur die kostenlose Hosted-Version. Wer schon Mealie oder Tandoor betreibt, wird hier noch nicht wechseln. Spannend finde ich aber den Ansatz, MCP und API von Anfang an mitzudenken – ähnlich wie bei Spliit für geteilte Ausgaben könnte das für Familien und WGs ein schönes Tool werden, wenn die Roadmap aufgeht. Social-Media-Import ist auf der „Todo Liste“ – bei uns gibt es viele Rezepte von Instagram
https://github.com/madeinpierre/cuicuit
❓ Feedback & Newsletter Abo
Vielen Dank, dass du es bis hierhin geschafft hast!
Kommentiere gerne oder schicke mir Inhalte, die du passend findest.
Falls dir die Inhalte gefallen haben, kannst du mir gerne auf Twitter folgen.
Gerne kannst du mir ein Bier ausgeben oder mal auf meiner Wunschliste vorbeischauen – Danke!
Möchtest du den Newsletter wöchentlich per E-Mail erhalten?
Einfach hier abonnieren: