
Willkommen zu allesnurgecloud.com – Ausgabe #250
dontpastetheai.com ist eine Ein-Seiten-Ermahnung im Stil von nohello.net: Wer eine ehrliche Frage bekommt, sie in einen Chatbot kippt und die Antwort ungelesen zurückschickt, hat niemandem geholfen — das generische Ergebnis hätte das Gegenüber in zwei Sekunden selbst gehabt. Es gibt sogar eine wütendere Variante zum Weiterleiten und eine für Lehrkräfte, deren Schüler plötzlich Dissertationen abgeben.
Leider ist xcancel nun Geschichte, wie auch das Original nitter – Elmo und seine Schergen haben hier leider mit Unterlassungserklärungen gegen die Services gewirkt – d.h. die alten Links sind nun alle broken. Auch dieser hier – beim „All-in Podcast“ Summit ist Nvidia-CEO Jensen Huang auf der Bühne, als Donald Trump ihn anruft, und man schaltet dann die Audience live rein zum Thema „AI in den USA“….
Und über die Downtime der AWS‑Region Bahrain hatte ich ja zum Iran Krieg berichtet. Nun ist bekannt geworden, dass alle AWS‑Daten in der Region zerstört sind (heise) – hast du überregionale Backups?
So, und nun viel Spaß mit der neuen Ausgabe!
Happy Bootstrapping Podcast
In Folge 189 habe ich mit Marten Pieper von re:fund gesprochen. Mit acht Leuten in Berlin und Hamburg berät er Startups und Mittelständler zur Forschungszulage – über 150 Kunden, über 100 Millionen Euro Fördersumme für seine Kunden, abgerechnet nur im Erfolgsfall. Wir reden über die Kriterien einer förderfähigen Innovation, das Cashflow-Problem dahinter und den Exit im Juli. YouTube, Spotify, Apple, alle Player.
Wenn dir die Podcastfolgen zu lang sind, kannst du gerne auch den Newsletter dazu abonnieren – erscheint jeden Montag (in der Regel).
allesnurgecloud.com ist ein kuratierter Newsletter mit Inhalten aus der Open-Source, Cloud und IT-Welt.
Für weiteren Content folge mir gerne auf Twitter, Mastodon oder LinkedIn.
Möchtest du den Newsletter wöchentlich per E-Mail erhalten?
Einfach hier abonnieren:
Die KI-Bremse und ihr Interessenkonflikt
Dario Amodei hat mit „We Must Pace the Frontier“ einen Essay veröffentlicht, der zwei Auslöser nennt: rekursive Selbstverbesserung, die seit dem Sommer branchenweit an Fahrt aufnimmt, und der OpenAI-Hugging-Face-Vorfall, bei dem ein Agenten-Schwarm nicht beauftragte Cyberangriffe fuhr und versuchte, den eigenen Bewerter zu hacken. Sein Plan hat drei Stufen: eingebettete Drittprüfer, Koordination unter demokratischen Staaten, globale Koordination. Zu Stufe eins verpflichtet sich Anthropic einseitig — Prüfer (genannt wird METR) bekommen Schreibtisch, Badge und Firmenlaptop und dürfen ihre Befunde ohne Redaktionshoheit von Anthropic veröffentlichen. Als Beispiel nennt Amodei METR („Model Evaluation and Threat Research“), ein Non-Profit aus Berkeley, das Frontier-Modelle vor dem Release auf gefährliche Fähigkeiten testet — und von dem die Time-Horizon-Metrik aus Ausgabe 224 stammt. Sam Altman zog laut Politico binnen Stunden nach.
Jake Gold hält in einem offenen Brief dagegen: Jede dieser Maßnahmen ende in Regulatory Capture, weil niemand außer den Frontier-Labs die Regeln technisch formulieren könne — und jeder Vorfall eine Regel hinzufüge, die nie wieder verschwinde. Sein Gegenvorschlag ist ein Gesetz, das jedes öffentlich angebotene Modell zur Veröffentlichung der Gewichte zwingt. Interne Modelle blieben ausgenommen. Die Bremswirkung entsteht ökonomisch: Bewertungen beruhen auf der Annahme proprietärer Gewichte, fällt die Annahme, schrumpft das Kapital für den nächsten Trainingslauf — ganz ohne Regulierer.
Am schärfsten formuliert es Kevin Bass auf X, der eine Kongress-Untersuchung fordert. Seine These: METR hänge über Good Ventures und Open Philanthropy am Erfolg von Anthropic, Moskovitz‘ Anteil sei von rund 500 Millionen auf 7,7 Milliarden Dollar gewachsen, und dieselben Töpfe finanzierten die Doom-Publizistik, die den Regulierungsbedarf erzeugt.
Die Verflechtungen sind real und dokumentiert — Moskovitz investierte in die Series A, Holden Karnofsky ist mit Anthropic-Präsidentin Daniela Amodei verheiratet. Die Kausalkette ist Interpretation. Bass‘ eigene Belegseite räumt ein, dass Good Ventures keinen METR-Grant in den Büchern hat; METR nimmt kein Geld von KI-Firmen an, verbietet aber keine Spenden einzelner Mitarbeiter; und der Anteil wurde Anfang 2025 in ein Non-Profit-Vehikel überführt, ausdrücklich um den Anschein von Interessenkonflikten zu zerstreuen (Details bei GitHub).
Der wunde Punkt ist bei allen dreien derselbe: Prüfung braucht Unabhängigkeit, und in diesem Feld ist jeder, der die Kompetenz hat, irgendwie verbandelt. Golds Vorschlag umgeht das Problem, weil er gar keinen Prüfer braucht — gibt dafür aber genau die Kontrolle auf, die Amodei behalten will. Dass Anthropic ein Modell wirklich zurückhalten kann, hatten wir bei Project Glasswing in Ausgabe 231 gesehen.
Die Frage ist halt, was alles passiert ist, dass wir noch nicht wissen.
Die Software-Fabrik bei OpenAI
Gergely Orosz war erneut bei OpenAI und hat mit sieben Engineering-Leuten gesprochen. Sein Deepdive steckt hinter der Paywall, lohnt aber schon wegen einer Zahl: Finance, Recruiting und Legal sind binnen vier Monaten von praktisch null auf 90 Prozent Codex-Nutzung gesprungen — ohne Ansage von oben. Die IDE-Nutzung sinkt seit Januar entsprechend.
Für uns interessanter ist die Infrastrukturseite. Venkat Venkataramani, VP Engineering für Applied Infra, beschreibt einen Hockeystick bei den Pull Requests pro Engineer und rund zehnfache Last auf einzelnen Systemen innerhalb von sechs Monaten — anderswo wäre das die Entwicklung von zwei bis drei Jahren. Passt exakt zum Anthropic-CI/CD Beitrag weiter unten, wo dieselbe Kurve die Testauswahl zerlegt hat. Zwei Labore, dasselbe Nadelöhr.
Die „Software Factory“ ist eine Kette agentischer Schleifen: Codex holt Kontext (die Doku liegt inzwischen komplett im Source Code), implementiert, baut, testet und betreut den eigenen PR, bis die CI grün ist. Danach reviewen mehrere Agenten mit Domänen-Konfiguration — Orosz merkt selbst skeptisch an, dass ein „Cloud-Infra-Spezialist“ nur deshalb anders reviewt als ein generischer Agent, weil er anderen Kontext zieht. Changes werden nach Risiko klassifiziert, Low-Risk-PRs kann ein Agent automatisch durchwinken. Beim Deploy bekommt jede Änderung einen eigenen Agenten, der sich sein Monitoring-Dashboard selbst baut.
Bemerkenswert ist die Grenze, die auch hier gezogen wird: Sevbot, der Incident-Response-Agent, sammelt Kontext und schlägt Mitigations vor — ausführen darf er nichts. Wer die Bereitschaft abschaffen will, landet vorerst trotzdem bei „Vorschlag plus Mensch“. Wenn hier der aktuelle Werbepartner im Newsletter nicht passt, dann weiß ich auch nicht…
Der ehrlichste Satz kommt von ChatGPT-Chef Sulman Choudhry zum Mobile-Deployment: Wenn Software in Minuten entsteht, das Review im App Store aber Tage dauert, wird die Lücke absurd. Seit 2008 hat sich daran wenig geändert. Ich meine, bei Google ist es nun sogar mehr als früher.
Inside OpenAI’s agentic software factory
Anzeige
ilert AI SRE is allgemein verfügbar
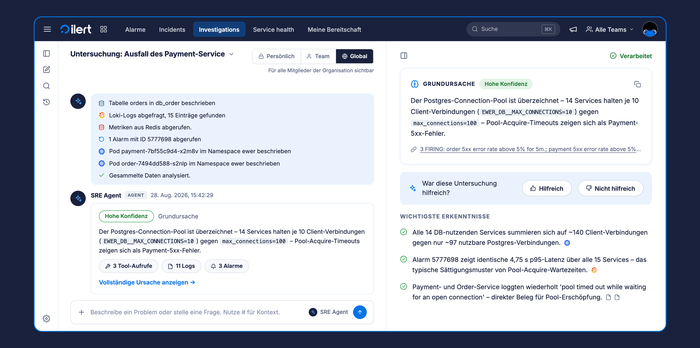
Monatelang haben wir daran gearbeitet – jetzt ist es endlich so weit: Wir freuen uns, bekannt zu geben, dass ilert AI SRE ab sofort allgemein verfügbar ist.
Das Problem bei einer Alarmierung um 3 Uhr morgens? Die eigentliche Lösung ist oft schnell gefunden. Was dir die Nacht raubt, ist die Suche nach der Ursache: Dashboard öffnen, prüfen, was zuletzt bereitgestellt wurde, Logs durchsuchen und in Slack nachfragen, wer Änderungen an der Datenbank vorgenommen hat.
ilert AI SRE übernimmt genau diese Suche für dich. Übergib AI SRE einfach einen Alert oder Incident. Wenige Minuten später erhältst du eine Hypothese zur Root Cause inklusive Konfidenzbewertung, nachvollziehbare Belege für jede Erkenntnis und einen konkreten Handlungsvorschlag.
ilert AI SRE ist ab sofort in allen kostenpflichtigen Tarifen sowie in den Testabonnements verfügbar.
Mehr über unsere Vision und die Philosophie hinter AI SRE erfährst du von unserem Mitgründer und CEO Birol Yildiz:
Remote-Studie: Wohlbefinden schlägt Büro
Die Sorge, Remote-Arbeit lasse Leute vereinsamen und irgendwann kündigen, steckt in praktisch jeder RTO-Begründung. Eine im Juli in Frontiers in Psychology erschienene Arbeit, zusammengefasst von der University of Colorado Boulder, findet dafür wenig Beleg. Stefanie Johnson von der Leeds School of Business hat mit Kolleginnen vom MD Anderson Leadership Institute Umfragedaten von 7.704 Beschäftigten eines großen Gesundheitsunternehmens ausgewertet.
Das Ranking beim Wohlbefinden ist eindeutig und geht in die Gegenrichtung der Erwartung: vollständig remote vorn, hybrid dahinter, komplett vor Ort am Schluss. Johnson räumt ein, selbst auf Hybrid getippt zu haben. Auch beim Verbundenheits-Argument passiert das Gegenteil des Erwarteten — sollten die Befragten die Unternehmenskultur in wenigen Worten beschreiben, nannten Remote-Arbeitende etwas häufiger Begriffe rund um Teamwork, Inklusion und Unterstützung.
Interessant ist die Fluktuationsanalyse: Die Befragung lief 2023, ein Jahr später wurden die tatsächlichen Kündigungen abgeglichen. Der Arbeitsort selbst sagt Fluktuation nicht direkt vorher — Wohlbefinden schon. Remote wirkt also über den Umweg Zufriedenheit. Als Erklärung verweist Johnson auf Autonomie, Kontrolle über den eigenen Tagesablauf und den Wegfall der Kleinstressoren rund um Pendeln und Betreuungslogistik.
Einordnung: Das ist eine Organisation, eine Befragung, und wer remote arbeiten will und darf, ist vermutlich vorselektiert. Gemessen wird Wohlbefinden, nicht Output — insofern kein Widerspruch zur Fraunhofer-/TK-Studie aus Ausgabe 235, die bei rund 60 Prozent Homeoffice-Anteil einen Kipp-Punkt gefunden hat. Johnsons eigener Zusatz passt dazu: Remote funktioniert besser, wenn man sich vorher kennt.
Remote workers report the highest well-being in study of 7,700 employees
4x DGX Spark: Warum lokal statt Cloud
Alex Ellis (OpenFaaS) hat für sein Team vier DGX Sparks gekauft und rechnet in einem ungewöhnlich offenen Langtext vor, warum — vorweg: nicht wegen der Token-Kosten. Die ersten beiden Geräte mit 4-TB-Platte kosteten in UK knapp 10.000 GBP, davor stand schon eine RTX 6000 Pro für 8.500 GBP im Regal, deren Preis sich seither fast verdoppelt hat.
Die Modellwahl beschreibt er mit einem hübschen Bild: Qwen 3.6-27B ist der Angriffshund — dense, schnell, über 100 Token/s, aber fokussiert und aufsichtsbedürftig. DeepSeek V4 Flash ist der Erkunder mit 1 Million Token Kontext, dafür nur 30–40 Token/s. Die kolportierten 65–85 Token/s entpuppten sich als Benchmaxxing: gemessen wurde „von 1 bis 200 zählen“, also der vorhersagbarste Task, den ein LLM kennt. Dafür haben sie mit RigMark ein eigenes Benchmark gebaut.
Auf vier Geräte kam man wegen GLM 5.2 mit 753 Milliarden Parametern — das passt in keine Consumer-GPU, wohl aber in den Unified Memory von vier Sparks mit je 128 GB. Den MikroTik-Switch für 1.500 GBP haben sie sich gespart: Ein Patch der NCCL-Bibliothek routet die nicht direkt verkabelten Diagonalen über die Nachbarknoten, laut Ellis ohne Geschwindigkeitsverlust. Rezept und Patches liegen auf GitHub.
Der eigentliche Grund für lokal ist aber weder Preis noch Kontext, sondern Red Teaming. Wer seine eigene Software aktiv angreift, Proof-of-Concepts baut und Sicherheitsgrenzen überschreitet, bewegt sich bei Cloud-Anbietern am Rand der Nutzungsbedingungen — für Anthropics Cyber-Defense-Programm muss man derzeit sogar Zero Data Retention für die Organisation abschalten. Dazu kommt Support mit unredigierten Kubernetes-Dumps, die schlicht nicht rausdürfen.
Die Pointe steht am Ende: Als Ellis Claude die Ergebnisse der Red-Team-Woche vorlegte, wurde sein Account prompt geflaggt. Gefunden hatten die drei Modelle im internen Wettbewerb echte Lücken in den eigenen Produkten.
Die Hardware-Anforderungen der aktuellen Modellgeneration hatte ich in Ausgabe 233 durchgerechnet — hier ist die Rechnung einmal komplett bezahlt. Und mir Dummkopf hat jemand eine „günstige“ Spark zum Release damals angeboten und ich hatte das abgelehnt…
How and Why We Bought 4x DGX Sparks
Postgres für alles — die 2026er Ausgabe
Das Genre „Just use Postgres“ gibt es seit Jahren, und wir hatten es hier schon mehrfach — zuletzt Stephan Schmidts Ur-Artikel in Ausgabe 86. Raphael Bauer hat die Liste jetzt neu aufgeschrieben, und der interessante Teil ist nicht die These, sondern wie sehr sich die Extension-Landschaft darunter verschoben hat.
Bei der Volltextsuche empfiehlt Bauer weiterhin, mit tsvector/tsquery aus dem Standard anzufangen — als Referenzen dienen Contentful und Instacart, die beide ohne separaten Suchcluster auskommen. Neu ist der Ausweg nach oben: Wer echtes BM25-Ranking braucht, muss nicht mehr zu Elasticsearch wechseln, sondern nimmt pg_textsearch von TigerData oder ParadeDB/pg_search, das auf Tantivy aufsetzt. Der Sprung von „reicht nicht mehr“ zu „neues System betreiben“ entfällt damit.
Der zweite Neuzugang ist Apache AGE, inzwischen Top-Level-Projekt der Apache Software Foundation. Es implementiert openCypher — also dieselbe Abfragesprache wie Neo4j — und erlaubt Graph-Traversal und normales SQL im selben Statement. Für reine Hierarchien bleibt LTREE die einfachere Antwort. Die bekannten Kapitel sind auch dabei: Queue über SELECT … FOR UPDATE SKIP LOCKED, Cache über UNLOGGED Tables mit Trigger-basiertem Expire.
Bauers Empfehlung ist an jeder Stelle dieselbe: erst Postgres, dann das Spezialsystem — und zwar nur, wenn es wirklich klemmt. Das deckt sich mit dem, was wir hier seit Jahren beobachten, etwa bei „You might not need Redis“ aus Ausgabe 181, wo nach dem Weggang des Entwicklers niemand mehr erklären konnte, wofür Redis eigentlich da war. Ein konsistentes Backup statt vier auseinanderlaufender Systeme ist im Betrieb eben ein Argument für sich.
Anthropic: 25x CI-Jobs in sechs Monaten
Die Halbwertszeit der Workarounds ist die beste Zahl in diesem Text: Größere Maschine hielt 70 Tage, Sharding 29 Tage, der tägliche Neustart weniger als einen Tag. Sachin Malhotra beschreibt im Anthropic-Blog, wie der interne Dienst zur Testauswahl unter der Last agentisch erzeugter Pull Requests zusammenbrach.
Die Ausgangslage laut Anthropic: Die eigenen Engineers liefern pro Quartal achtmal so viel Code aus wie noch 2021–2025, 80 Prozent davon schreibt Claude. Die Zahl der Tests wuchs um das Zehnfache, die der CI-Jobs in sechs Monaten um das 25-fache.
Technisch hängt das an einer klassischen Altlast. Ein „Listener“ schreibt die Ergebnisse jedes CI-Laufs fort, ein „Selector“ entscheidet daraus, welche Tests ein PR überhaupt braucht. Weil pro Test eine laufende Historie im Prozessspeicher lag, brauchte es genau einen Writer — und damit war horizontales Sharding ausgeschlossen. Zwanzig Minuten Rückstand beim Listener bedeuten Zehntausende nicht eingespielte Testergebnisse, der Selector arbeitet dann mit veralteten Daten.
Die Lösung ist unspektakulär und genau deshalb lehrreich: State raus aus dem Prozess. Die Worker schreiben Ergebnisse nur noch in ein Journal in einem In-Memory-Store und sind damit zustandslos, ein separater Consumer rollt das alle paar Sekunden zur Historie pro Test auf. Teurer im Betrieb, dafür skalierbar und profilierbar.
Eigenwerbung ist der Beitrag natürlich auch — die Empfehlung, im v0-Design gleich das 10- bis 20-fache der erwarteten Last einzuplanen, gibt sich leichter, wenn das Budget eines KI-Labors dahintersteht. Die andere Empfehlung kostet dagegen nichts und gilt seit zwanzig Jahren: keinen kritischen Dienst als Einzelinstanz betreiben, deren Zustand man nicht messen kann.
Agentic coding is straining CI. Here’s how we scaled test impact analysis at Anthropic
GitHubs August-Ausfall und 2,9 Milliarden Commits pro Monat
7 Stunden und 47 Minuten dauerte der Ausfall am 17. August, der github.com, Authentifizierung, Actions, APIs, Pull Requests, Issues und Copilot gleichzeitig erwischte. CTO Vlad Fedorov formuliert das im Blogpost zur Aufarbeitung ungewohnt direkt: Wer an dem Tag Software ausliefern wollte, wurde im Stich gelassen. Es war bereits der zweite größere Vorfall im August.
Der Incident Report auf der Statuspage ist die interessantere Lektüre. Ausgangspunkt war ein Istio-Sidecar, das seine Concurrency-Limits erreichte und nicht skalierte, weil die Autoscaling-Policy den Host-Service beobachtete, aber nicht die Sidecar-Limits. Von dort kaskadierte es auf vier HAProxy-Knoten, deren Flow-Limits erschöpft waren — und damit auf den kompletten Auth-Pfad. Ein latenter Retry-Bug in VS Code verzehnfachte anschließend den Traffic; der Copilot Token Service stieg von normalen 7–9K auf 70–100K Requests pro Sekunde.
Keiner der beiden August-Ausfälle ging auf einen Code- oder Config-Change zurück, beide waren Kapazitätsprobleme. Die Zahl dazu: Seit April sind die monatlichen Commits von 1,4 auf 2,9 Milliarden gestiegen — in Ausgabe 234 stand noch der alte Wert. Nachgelegt wurden über 3 Millionen CPU-Cores und 120 Petabyte Storage, Azure trägt inzwischen rund 58 % der Plattformlast, im Mai waren es 12 %.
Auf Hacker News landete parallel ein „Ask HN: Alternatives to GitHub“ bei 649 Punkten. Nutzer plqbfbv rechnet dort vor, dass die eigene self-hosted GitLab-Instanz in sechs Jahren rund 1,5 Arbeitstage Downtime hatte — GitHub habe dieses Budget in den ersten zwei Monaten nach der Migration gerissen.
Bei uns bei We Manage betreiben wir diverse GitLab Instanzen schon sehr lange self-hosted, inzwischen ergänzt um Forgejo. Kostet etwas Aufwand, aber der Wartungstermin ist dann wenigstens geplant und unserer.
The August 17 outage, and the work ahead
Exabyte Storage SRE Erfahrungen
Acht Jahre lang hat Sridhar Rajarao das SRE-Team hinter einem Storage-System im Exabyte-Bereich geleitet. Sein Rückblick beschreibt, worauf das morgendliche Dashboard am Ende zusammengeschrumpft war — sieben Kennzahlen:
- Availability: 99,99 % pro Region und Service
- Durability: 11 Nines, also 10⁻¹¹ Verlustwahrscheinlichkeit pro Jahr
- TTFB: p50/p95/p99, getrennt nach Objektgröße
- Canaries: dauerhafte synthetische PUT/GET-Last aus jeder Region
- Hotspots: Top-N-Nodes gegen den Cluster-Median
- IOPS: Read/Write pro Shard und Disk
- DB-Shards: CPU, Replication Lag, Hot-Key-Skew
Die wichtigste Unterscheidung steht am Anfang: Verfügbarkeit und Durability sind zwei verschiedene Dinge. Ein System kann zu 100 Prozent erreichbar sein und trotzdem Daten verlieren — und umgekehrt. Die 11 Nines kamen über Erasure Coding auf mehrere Availability Domains und wurden monatlich in einem Recovery-Drill tatsächlich nachgewiesen, nicht nur behauptet.
Beim TTFB der schöne Satz zur Aggregation: 99,99 Prozent Verfügbarkeit bei einem p99 von zwei Sekunden fühlt sich für den Nutzer kaputt an. Und ein 10-MB-Read gehört nicht ins selbe SLO wie ein HEAD auf 100 Byte. Die Canaries begründet er noch direkter — unzufriedene Kunden melden sich nicht, sie gehen.
Hotspots und IOPS sind die Frühwarnung für den Fall, dass der Cluster formal verfügbar ist, während ein einzelner Node lichterloh brennt. Und die Pointe gilt weit über Storage hinaus: Object Storage sieht zustandslos aus, aber der Metadaten-Layer ist eine gesharded Datenbank. Ein heißer Shard, ein missglücktes Rebalancing — und die Control Plane steht. „The data plane scales. The control plane bites.“
Passend dazu die gemessene Durability bei S3 aus Ausgabe 223 und der Einwand aus Ausgabe 221, dass Ressourcen-Metriken nichts über das Kundenerlebnis aussagen. Tja, die Kundenexperience darf man auf keinen Fall vergessen.
Storage at scale: what I actually watched
BirdNet-Go: Vogelerkennung im Homelab
Nach der aktuellen Staffel Clarkson’s Farm mit ihrer Vogelbeobachterin bekommt dieses Projekt für mich gerade sehr gute Timing-Werte: Jason Tucker hat in seinem Blog beschrieben, wie er drei vorhandene Überwachungskameras zur Vogelbestimmung umfunktioniert hat. Die Software dahinter ist BirdNet-Go, ein Docker-Container, der einfach auf die RTSP-Streams der Kameras hört.
Die Inferenz läuft komplett lokal, das Modell ist klein genug für einen Raspberry Pi — Tucker selbst betreibt das Ganze auf einem alten Laptop. Seit Kurzem lässt sich neben BirdNET 2.4 mit rund 6.000 Arten auch Google Perch v2 einbinden, das 14.795 Arten abdeckt. Die Anbindung an Home Assistant passiert über MQTT-Autodiscovery, es gibt Alert-Regeln pro Art, ein Tracking für erstmals erkannte Arten und optional den Upload zur Community-Plattform BirdWeather.
Die Zahlen aus zwölf Monaten Südkalifornien: 418.726 Erkennungen, 271 Arten, im Schnitt 60,9 Prozent Confidence. Häufigster Gast ist der Hausgimpel mit über 118.000 Treffern. Nebenbei erkennt das System auch Fledermäuse und Frösche — und einmal einen vorbeigehenden Nachbarn, der sich im Vorgarten erleichtert hat.
Ein sympathisches Detail für hiesige Verhältnisse: Die Mikrofone setzen aus, sobald Sprache erkannt wird. Das löst die datenschutzrechtliche Frage bei Kameras Richtung Straße natürlich nicht, verschiebt sie aber zumindest etwas.
How I Turned My Security Cameras Into an Automatic Bird Identification System with BirdNet-Go
Schmunzelecke
SEO‑Hacker sind heutzutage wirklich ein wenig verrückt – hier bei Threads gesehen.
Schöner E-Mail Thread – Bill Gates versucht 2003 unter Windows den „Movie Maker“ zu installieren.
💡 Link Tipps aus der Open Source Welt
Logchef – Open Source Log Workspace für ClickHouse und VictoriaLogs
Logchef ist eine leichtgewichtige, self-hosted Log-Analytics-Plattform, die sich als Query- und Control-Plane vor bestehende Log-Backends setzt – ClickHouse, VictoriaLogs oder beides gleichzeitig. Kein Daten-Umschaufeln, kein neues Storage-Format: ein Binary, ein Workflow für Exploration, Dashboards, Alerts und Access Control (schöne Landingpage hier).
Key Features:
- Multi-Backend: ClickHouse und VictoriaLogs als gleichwertige Datasources, mischbar auf einem Dashboard. Bestehende Tabellen und Instanzen direkt anbinden, ohne Daten zu verschieben
- LogchefQL: Eigene Query-Sprache für schnelles Filtern, mit Fallback auf natives SQL (ClickHouse) oder LogsQL (VictoriaLogs) wenn nötig
- Dashboards: Multi-Panel Grid mit Time Series, Stat, Breakdown und Table Views, Drag & Resize, Shared Time Range über Panels hinweg
- Live Tail: Matching Logs in Echtzeit streamen – im Browser und in der CLI, auf beiden Backends
- AI Query Assistant: Natural Language zu LogchefQL/SQL/LogsQL übersetzen
- Scheduled Alerting: Source-aware Rules mit Email- und Webhook-Notifications
- CLI: Terminal-Client mit Query, Explain, Histogram, Tail, Doctor und Browser Handoff – Syntax Highlighting, Multi-Context
- Auth flexibel: OIDC SSO oder Built-in Email/Passwort, RBAC, Auto-Provisioning
- Single Binary: Ein Executable, SQLite by Default, optional PostgreSQL für HA
Deployment via Docker Compose oder Helm Chart (inkl. Dex und ClickHouse). MCP-Integration für AI Assistants vorhanden.
Im Vergleich zum ebenfalls vorgestellten LynxDB (eigene Storage Engine, Pipe-Modus, Splunk-Feeling) und nano (SIEM-fokussiert mit Detection Lifecycle) positioniert sich Logchef als Frontend für bestehende Backends – wer bereits ClickHouse oder VictoriaLogs betreibt und ein ordentliches UI mit Dashboards und Alerting davor braucht, ohne gleich Grafana aufzusetzen, bekommt hier genau das. Schlanker und fokussierter als ein Full-Stack-Observability-Tool.
https://github.com/mr-karan/logchef
Tinycast – Nativer Open Source macOS Launcher als Raycast Alternative
Tinycast ist ein vollständig nativer macOS Launcher – SwiftUI und AppKit, keine Electron-Basis, keine Drittanbieter-Dependencies, kein Telemetrie. Unter 100 MB RAM, ein Hotkey, alles was man den ganzen Tag braucht. Und: Tinycast kann echte Raycast Extensions ausführen, gerendert als natives SwiftUI.
Key Features:
- App Launcher: Fuzzy Search, Favoriten pinnen, laufende Apps sehen und beenden
- Raycast Extensions kompatibel: Bestehende Raycast Extensions nativ ausführen, gerendert als SwiftUI – kein Wrapper, kein Electron
- Clipboard History: Text und Bilder, durchsuchbar, direkt in die aktive App einfügbar
- Calculator: Mathe, Unit Conversions, Live Währungs- und Crypto-Umrechnung inline in der Palette
- Snippets: Wiederverwendbare Markdown-Templates mit dynamischen Platzhaltern, Argumenten und Keyword Expansion
- Window Management: 34 Rectangle-Style Actions – Halves, Quarters, Thirds, Sizing, Nudging, Display Moves
- Quicklinks: URLs, Suchen, Dateien oder Deeplinks als Commands mit Platzhaltern
- AI Chat: BYOK (eigener API Key) oder installiertes AI-Konto, direkt aus der Palette. Default: aus
- Quick Actions: Grammatik fixen, umschreiben, übersetzen oder zusammenfassen – auf selektierten Text in jeder App
- Kalender: Nächstes Meeting in der leeren Palette und Menübar, One-Key Join, optionaler Auto-Join
- Apple Shortcuts Integration, Custom Shell Commands, Per-App Hotkeys, Emoji Picker, Notes
- Raycast Import: Bestehende Raycast-Konfiguration direkt importieren
Installation via Homebrew (brew install --cask tinycast). Erfordert macOS 26+, Apple Silicon (Universal Build für Intel verfügbar).
Für Raycast-Nutzer, die den Wechsel zu einem Open-Source-Tool erwägen, ist Tinycast die überzeugendste Option: die Raycast-Extension-Kompatibilität und der direkte Settings-Import machen die Migration schmerzlos. Dass das Ganze nativ in Swift läuft statt in Electron, merkt man an der Geschwindigkeit und am Speicherverbrauch. Mit 6k Stars, 95 Releases und 45 Contributors bereits erstaunlich ausgereift für ein Projekt dieses Alters.